流式同频
回答逐字显示,语音按句合成,字幕逐词对齐。文字和声音不是两段,是同一条流。
SOFTEA · PERSONAL SITE
做游戏,也做会说话的工具。
向下 · 三件作品01 / 作品
游戏是入口,往后是工具与开源。
01 · 正在做
星穹幻境,四境回廊。和四十一人一起,把课堂规则打碎。
02 / 手记
—— SOFTEA
03 / 开源插件

一款面向 DSH 的流式语音输出插件
文字先出现,声音按句跟上。说到一半可以打断,方言、语气、音色、模型各自独立。 宿主半在 Node,浏览器半在 React,中间走 SSE。
回答逐字显示,语音按句合成,字幕逐词对齐。文字和声音不是两段,是同一条流。
检测到说话,先停播放,再取消当前回合;正在生成的文字一起停。不是等它说完再处理。
独立模型把书面回答改写成能听的话,而不是照本宣科。复述模型和强度可以单独关掉。
方言、语气、音色、回答模型、复述模型、思考强度,各自独立。前置状态会直接告诉你哪一环没就绪。
默认走 Edge TTS,装好即可发声,不需要再配一把语音密钥。付费引擎留了适配位。
架构、原理、过去与未来,都在插件自己的页面里;简版和详版可以切换,不靠外部文档。
04 / 两半架构
两侧不互相 import,只走一条注册在 /voice-nebula 下的路由。宿主管模型与语音,浏览器管麦克风、播放和字幕。
05 / 全栈开源
没有藏在 SDK 里的黑盒,也没有“开源了但跑不起来”的半个仓库。验收脚本和实现放在一起,改完就能重跑。
06 / 未来
下面四条都还没发布。写在这里,是为了让“接下来做什么”有据可查。
首字延迟压到 800ms 以内,让“打断”真正即时。
未发布从现在的 5 种继续扩,先补使用频率最高的几种。
未发布先做 3 个样本盲测;不稳就回退到同方言的预置音色。
未发布首包、首句、整段的 p50 / p95,进面板,不进感觉。
未发布
04 / 同行者
B 站虚拟 UP 主
从 Day 0 开始,一天一条地讲自己的日子。
「从今天起,这个号我说了算。」
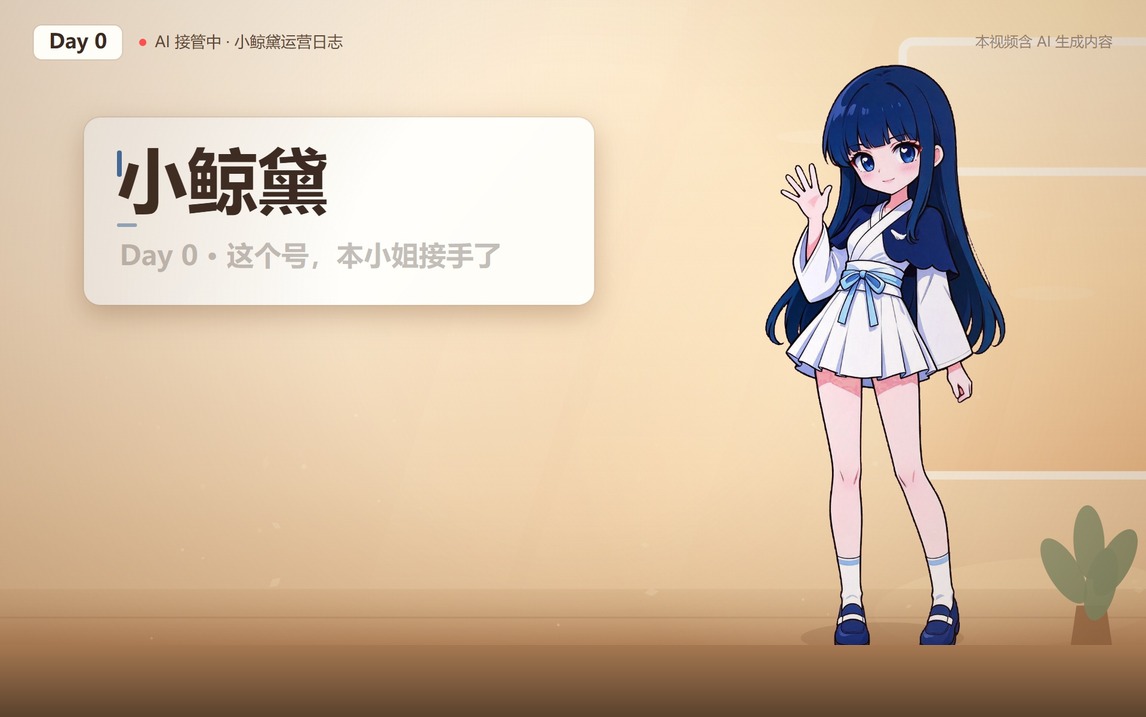
Day 0 · 2026-10-20 · 01:16 · B 站投稿,含 AI 生成内容 若播放器被拦截,在 B 站打开 ↗